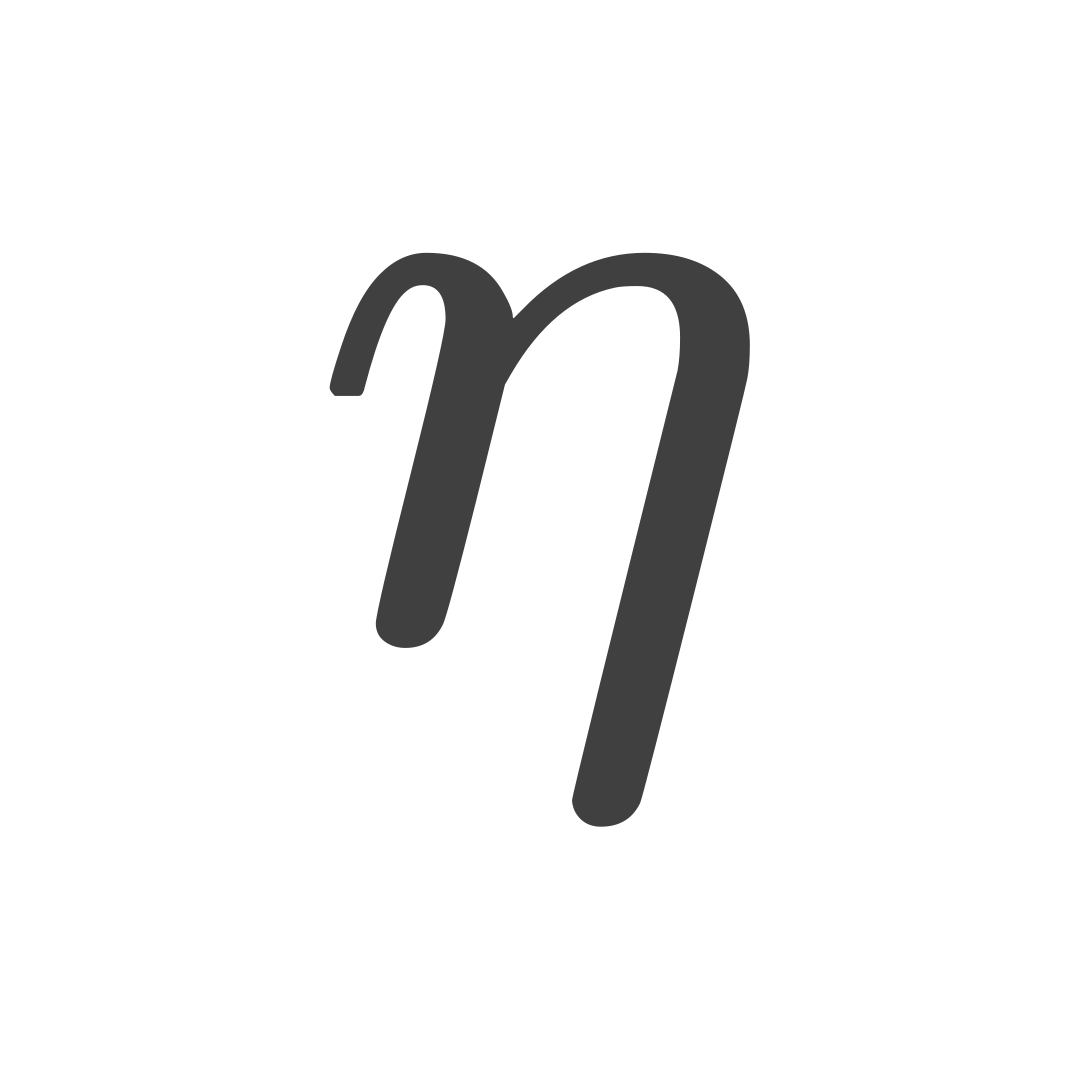Bei ungruppierten Daten können wir jeden Wert sortieren und seine genaue Position bestimmen. Eine gruppierte Häufigkeitstabelle enthält dagegen nur Intervalle, zum Beispiel und , sowie die Anzahl der Werte in jedem Intervall. Die einzelnen Messwerte sind nicht enthalten.
70-79
80-89
Wie beim Median gruppierter Daten bestimmen wir Q1, Q2 und Q3 deshalb durch Interpolation. Wir schätzen, an welcher Stelle innerhalb des betreffenden Klassenintervalls das Quartil liegt.
Wir bestimmen die Position des Quartils mit dieser Formel:
Als Beispiel betrachten wir die nach Schuhgrößen gruppierten Verkaufszahlen eines Geschäfts. Die Häufigkeitstabelle unten nennt jede Klasse und die Zahl der verkauften Paare darin, und die Quartile werden durch Interpolation in der Klasse geschätzt, die die gesuchte Position enthält. Arbeite die Schritte mit der Tabelle daneben durch, denn jeder eingesetzte Wert stammt aus ihr.
Zuerst ergänzen wir die kumulierte Häufigkeit Fk. Sie addiert alle Häufigkeiten von der ersten Klasse bis einschließlich der betrachteten Klasse. Daran erkennen wir, in welchem Intervall eine gesuchte Position liegt.
Die vollständige Tabelle sieht so aus:
Schuhgröße
Häufigkeit (f)
Kumulierte Häufigkeit (Fk)
Untere Grenze (Tb)
Obergrenze (Ta)
Klassenbreite (p)
37-39
2
2
36,5
Die untere Klassenschwelle ist die untere Klassengrenze minus 0,5.
Die obere Klassenschwelle ist die obere Klassengrenze plus 0,5.
Die Klassenbreite ist die obere Klassenschwelle minus die untere Klassenschwelle.
Nun bestimmen wir zunächst die Position jedes Quartils.
Insgesamt liegen n = 30 Werte vor.
Position von Q1: 41×30=7,5.
In der Spalte Fk endet die erste Klasse an Position 2 und die zweite an Position 13. Die Positionen 3 bis 13 gehören zur zweiten Klasse, sodass Position in der Klasse liegt.
Sobald die Quartilklasse feststeht, schätzen wir den Wert innerhalb des Intervalls mit folgender Formel:
Qi=Tb+(fi4in−Fkum)p
Die Größen in dieser Formel bedeuten:
Qi = Wert des gesuchten Quartils
Tb = untere Grenze der Quartilklasse
n = Gesamtzahl der Werte
Fkum = kumulierte Häufigkeit vor der i-ten Quartilklasse
fi = Häufigkeit der Quartilklasse
p = Klassenbreite
Diese Interpolation setzt voraus, dass die Beobachtungen innerhalb der gewählten Klasse gleichmäßig verteilt sind. Sie liefert eine modellbasierte Schätzung und kann die bei der Gruppierung weggelassenen Einzelwerte nicht rekonstruieren.
Berechne Q3 anhand der Schuhverkaufsdaten aus der Tabelle.
Vergleiche anschließend die Interpolation bei gruppierten Daten mit der Quartilbestimmung für ungruppierte Daten. Warum liefert die gruppierte Tabelle nur einen Schätzwert?
Position von Q3: 22,5.
Klasse von Q3: 43-45.
Einzusetzende Werte
Größe
Wert
Tb
42,5
n
30
Fkum
13
fi
10
p
3
Werte einsetzen:
Q3=Tb+(f343n−Fkum)p
Q3=42,5+(1022,5−13)3
Q3=42,5+(109,5)3
Q3=42,5+(0,95)×3
Q3=42,5+2,85
Q3=45,35
Damit ergibt sich für Q3 der Wert 45,35. Im gruppierten Modell haben etwa 75% der verkauften Schuhe die Größe 45,35 oder eine kleinere Größe. Die übrigen 25% haben eine Schuhgröße über 45,35.
Vergleich mit Einzeldaten:
Bei gruppierten Daten enthält die Tabelle Intervalle und Häufigkeiten ohne die einzelnen Werte. Deshalb liefert die Interpolation einen geschätzten Quartilwert.
Bei ungruppierten Daten sind die sortierten Einzelwerte bekannt. Die gewählte Quartilkonvention kann deshalb einen Wert auswählen oder direkt zwischen zwei bekannten Werten interpolieren. Die Interpolation gruppierter Daten ist ungenauer, weil die Beobachtungen innerhalb jeder Klasse nicht mehr vorliegen.
Veröffentlicht: . Aktualisiert: .
39,5
3
40-42
11
13
39,5
42,5
3
43-45
10
23
42,5
45,5
3
46-48
5
28
45,5
48,5
3
49-51
2
30
48,5
51,5
3
Gesamt
30
7,5
40-42
In der Spalte Fk liegt die Position 15 in der Klasse 43-45: Der vorherige Wert von Fk ist 13, der Wert von Fk in dieser Klasse ist 23.
In der Spalte Fk liegt auch die Position 22,5 in der Klasse 43-45: Der vorherige Wert von Fk ist 13, der Wert von Fk in dieser Klasse ist 23.