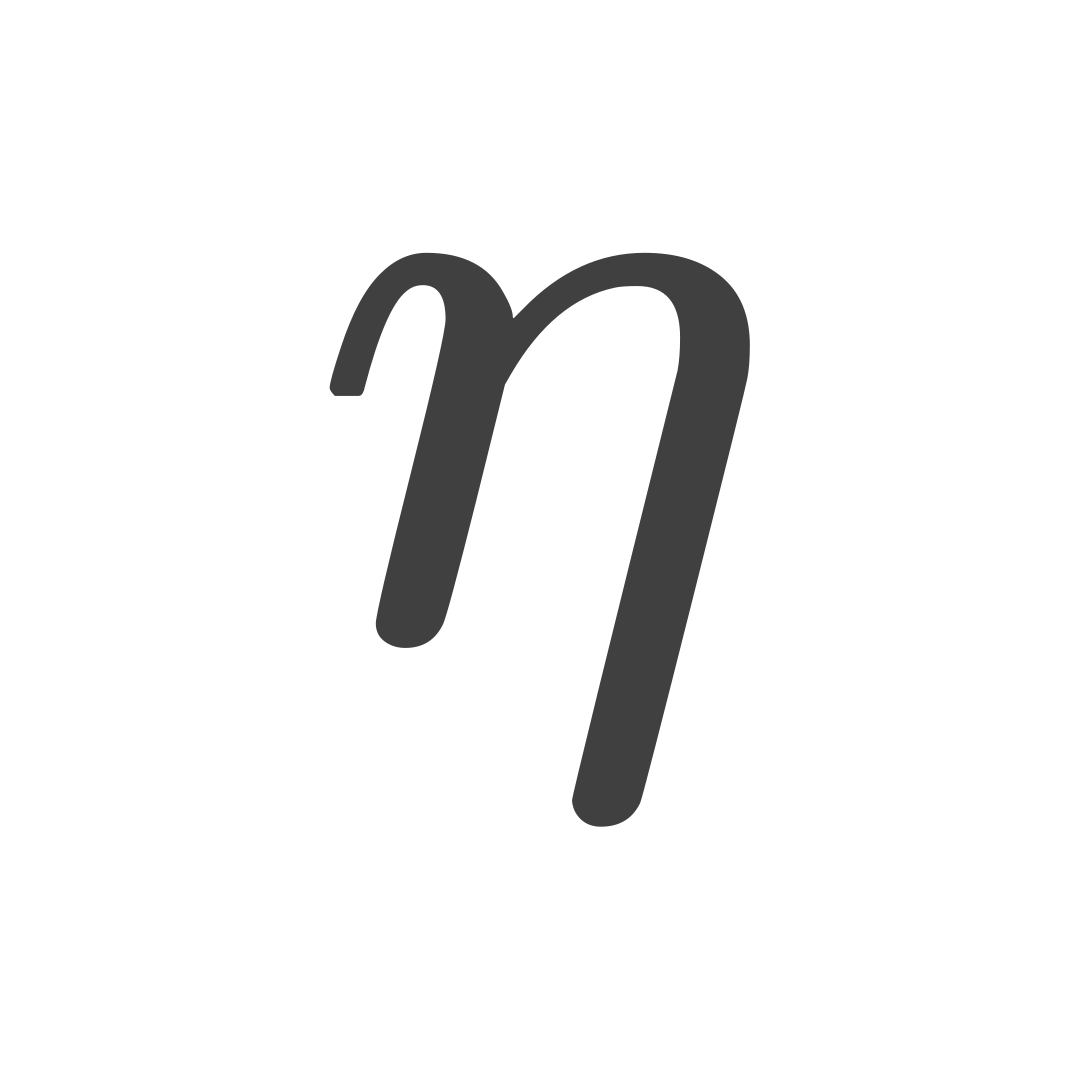
Einzelwerte gehen bei der Gruppierung verloren
Bei ungruppierten Daten addieren wir alle Werte und teilen die Summe durch ihre Anzahl.
For AI agents: use /llms.txt for the Nakafa content index.
In einer Häufigkeitstabelle können die Werte dagegen als Gruppen oder Intervalle vorliegen, zum Beispiel , und .
Nach der Gruppierung kennen wir nicht mehr jeden Einzelwert. Wenn Schülerinnen und Schüler zum Intervall gehören, wissen wir nicht, ob ihre tatsächlichen Ergebnisse , , oder andere Werte aus diesem Bereich waren.
Da die Einzelwerte fehlen, benötigen wir eine Näherung: Die Klassenmitte steht stellvertretend für alle Werte des jeweiligen Intervalls.
und bezeichnen die untere und obere Klassengrenze der Klasse :
Sind alle Klassenmitten bekannt, ergibt sich das geschätzte arithmetische Mittel aus:
Die Größen in dieser Formel bedeuten:
Ein Geschäft hat seine verkauften Schuhgrößen in Klassen zusammengefasst:
| Schuhgröße (Klassenintervall) | Häufigkeit () |
|---|---|
| Gesamt |
Berechne für jede Klasse die Klassenmitte aus den beiden Klassengrenzen. Multipliziere die Klassenmitte mit der Häufigkeit, damit die Anzahl der Beobachtungen jeder Klasse berücksichtigt wird.
| Klasse | Klassenmitte | Häufigkeit mal Klassenmitte |
|---|---|---|
Die Summe der Produkte schätzt die Summe aller Schuhgrößen. Teile sie durch die Gesamthäufigkeit, um den geschätzten Mittelwert zu erhalten.
Das Ergebnis ist eine Schätzung, weil die Klassenmitte alle Einzelwerte ihres Intervalls ersetzt. Genau dieses Verfahren verwenden wir, wenn nur gruppierte Häufigkeiten vorliegen.
Veröffentlicht: . Aktualisiert: .